9月18日,阿里发布新一代全模态大模型Qwen3.8-Omni-Flash。新模型能统一处理文本、图像、音频和视频输入,在多项音视频权威评测中可媲美最新的Gemini3.8-Flash,还拥有极强的Agentic能力,能自主规划任务、调用工具并交付结果,是国内首个全模态Agentic模型。用户提供歌曲、影视剧或会议视频并描述需求,模型即可配合Agent完成MV制作、影视剪辑、多人会议整理等任务。同时,相较上代模型,Qwen3.8-Omni-Flash输入价格骤降九成。
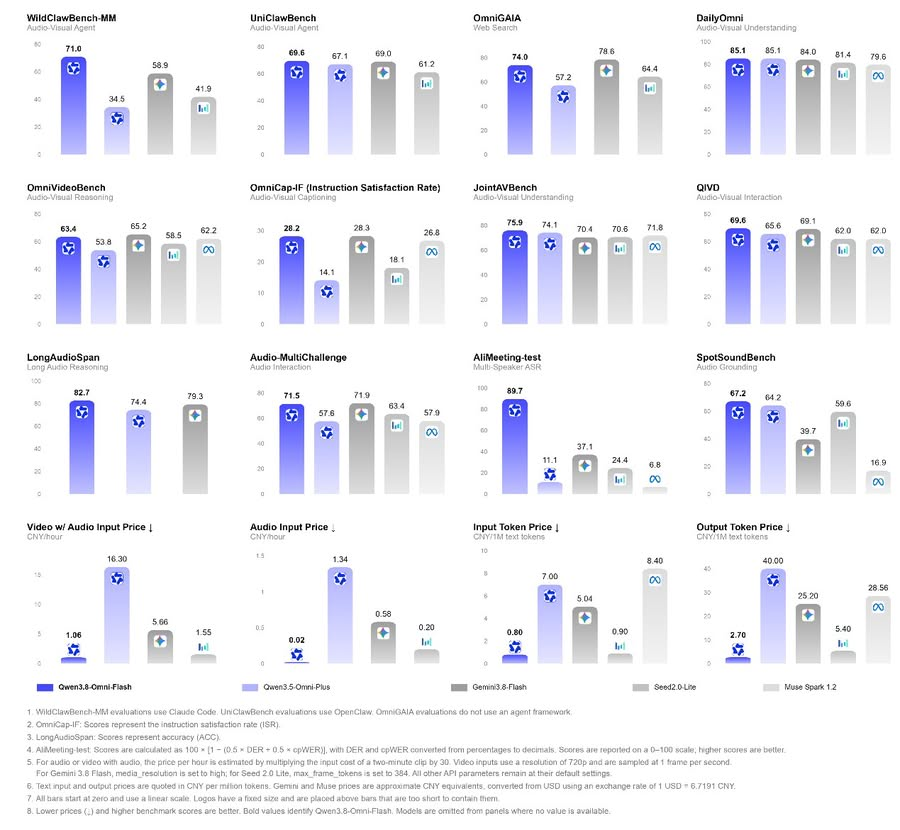
Qwen3.8-Omni-Flash采用全新架构,实现了全模态能力的显著提升。在累计30项评测上,相比上一代Qwen3.5-Omni-Plus,新模型平均得分提升超过26%。其中,长音频理解LongAudioSpan提升8.3分,音视频理解OmniVideoBench提升9.6分,覆盖音视频Agent、Coding和长程任务的WildClawBench-MM、AgenticVBench分别大幅提升36.5分和22.3分。通过扩展数据、上下文与Agentic环境,Qwen3.8-Omni-Flash的音频能力整体超过最新的 Gemini3.8-Flash。 同时,新模型支持113种语言及方言识别、36种语言及方言生成和百万上下文,可处理时间更长、人员角色更复杂的音视频内容。
音视频作为Agent走向真实生产力场景的重要载体,通常会面临文件存储、多轮推理成本高昂等痛点。Qwen3.8-Omni-Flash通过与Harness工具和运行环境协同演进,提出了全新的解决方案。升级后的新模型,面对数小时的长音视频,可以“带着问题找答案”,根据音画线索自主定位关键片段进行多轮分析,将计算集中在核心内容上。结果显示,这种Agentic理解方式相比传统的静态理解,在明显提升准确率的同时,Token消耗大幅下降了45.7%。
针对实时交互的AI需求,阿里还推出了新模型Qwen3.8-Omni-Flash-Realtime,同时进一步扩展多模态能力插件Qwen-MM-Plugins,并开源实时交互运行框架Qwen-Live Harness。其中,插件为长音视频的按需感知、工具调用与工作流执行提供支持,Qwen-Live Harness则为实时、持续的全模态交互提供原生运行环境,方便开发者快速上手与复现。

在音视频内容生产与知识沉淀等核心任务中,Qwen3.8-Omni-Flash展现出强大的端到端交付能力:在内容生产方面,新模型可与Qwen-MM-Plugins等工具协同,将素材理解、创意规划与成片质检串联起来,实现一句话让模型根据音乐生成MV、翻译短剧、解说影视剧等复杂需求;在知识沉淀方面,结合此次开源的Video2Note,Qwen3.8-Omni-Flash可联合理解语音、画面与操作过程,提炼知识结构与关键步骤,生成图文对应的PDF笔记;另一项开源能力Omni Skill Creator,则能从操作演示中提炼标准作业流程与关键经验,自动转化为经过校验的Agent Skill,供后续任务复用。
训练过程中,Qwen3.8-Omni-Flash还涌现出了“自我迭代”能力。它可以像一位真实的 AI 算法工程师一样,在12小时内通过自主选定测评集、完成基线测试、听取语音样本、构建针对性训练数据等复杂环节,有效提升Qwen2.5-Omni-3B的四川话识别能力,并交付可用模型。在连续4轮实验中,Agent累计构建了3413条训练数据,根据评测反馈调整方案、保留有效改进并回退无效尝试。最终,Qwen2.5-Omni-3B在同一评测集上的字符错误率下降约10%。
目前,Qwen3.8-Omni-Flash已上架千问AI平台,每小时音频、音视频上的平均输入价格降幅超过93%。普通用户也可前往Qwen Studio免费体验新模型。

- 从音视频理解走向Agentic任务交付,阿里发布全模态模型Qwen3.8-Omni-Flash – 2026年9月18日
- 医疗AI的下半场,从“能答”到“敢托付”——2026医学人工智能大会侧记 – 2026年9月18日
- 技术、研发、专利构建坚固护城河,摩尔线程连获四项民营企业重磅荣誉 – 2026年9月17日