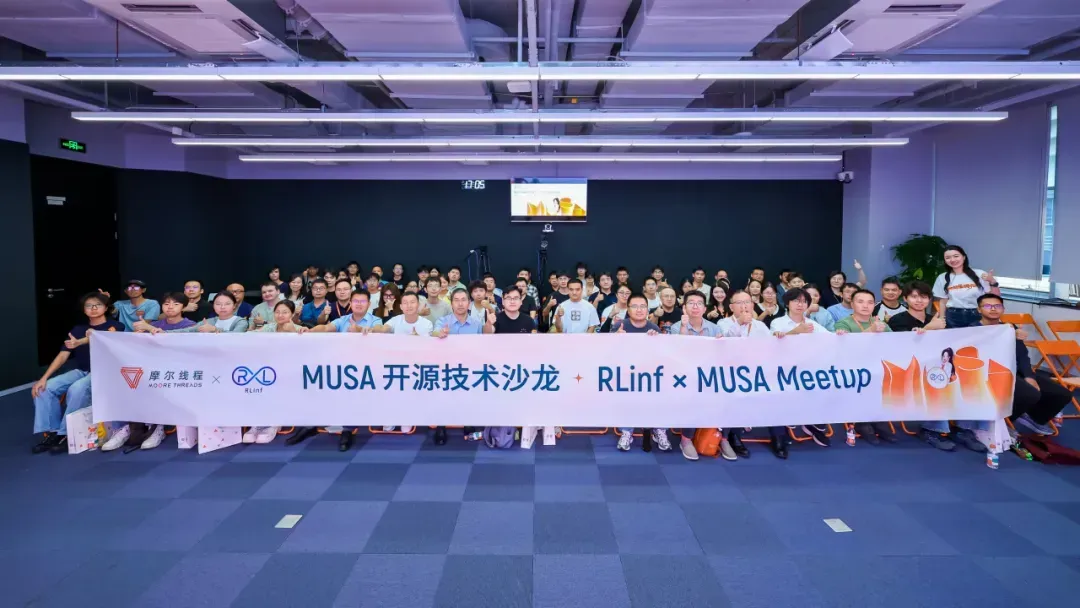
围绕这一目标,RLinf持续快速迭代,多项成果被NeurIPS、OSDI等顶级会议收录:M2Flow编程范式大幅降低了大规模RL系统的开发复杂度;Flow-Noise、Flow-SDE系列算法在四个主流测试集上带来30%~50%的性能提升;USER系统让开发者可以“像使用GPU一样使用机器人”;RL-Co实现了仿真与真机的联合训练。框架实验显示,RL后训练可使VLA模型的执行泛化能力提升超过30%。
谈及与摩尔线程的深度共建,于超表示, 渲染能力是关键考量:“摩尔线程是国内除国际主流GPU厂商之外,少数能在渲染环节提供成熟支持的算力伙伴。”此次官方CI的接入意味着国产算力与国产具身强化学习框架,已从单向“适配”进入双向“共建”阶段。
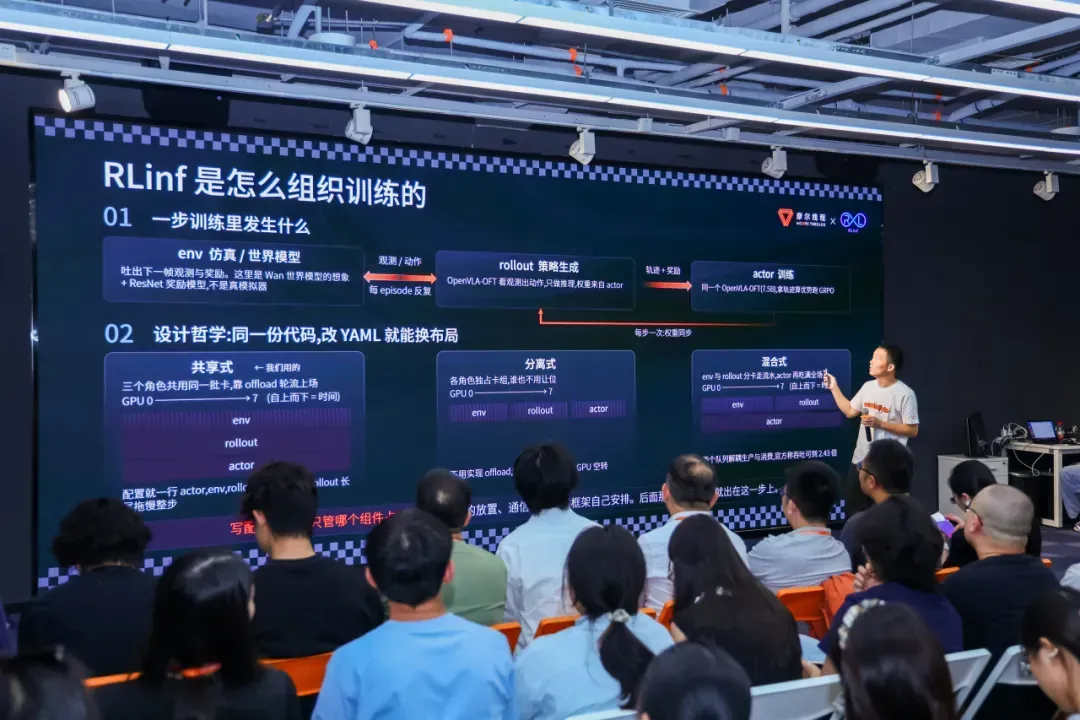
工程优化方面,摩尔线程团队对单步耗时逐相拆解后实施三项改造:图像处理从主机端迁移至GPU端;去噪循环的数值检查由每步5次合并为整轮一次;热路径上的Python标量替换为0维设备张量。改造后,整步耗时从2549秒降至1888秒(下降26%),env交互耗时降低14%,rollout出动作耗时降低20%,GPU空转率由18.5%压缩至3.1%;算子级基准测试显示,S5000的GEMM与注意力性能达到国际主流GPU的1.6-2倍。
团队同时披露了面向具身操作的4DGS高保真场景重建方案,可从操作台的多目视频端到端重建3D动态场景,为RL后训练与Sim2Real提供数据与评估支撑。
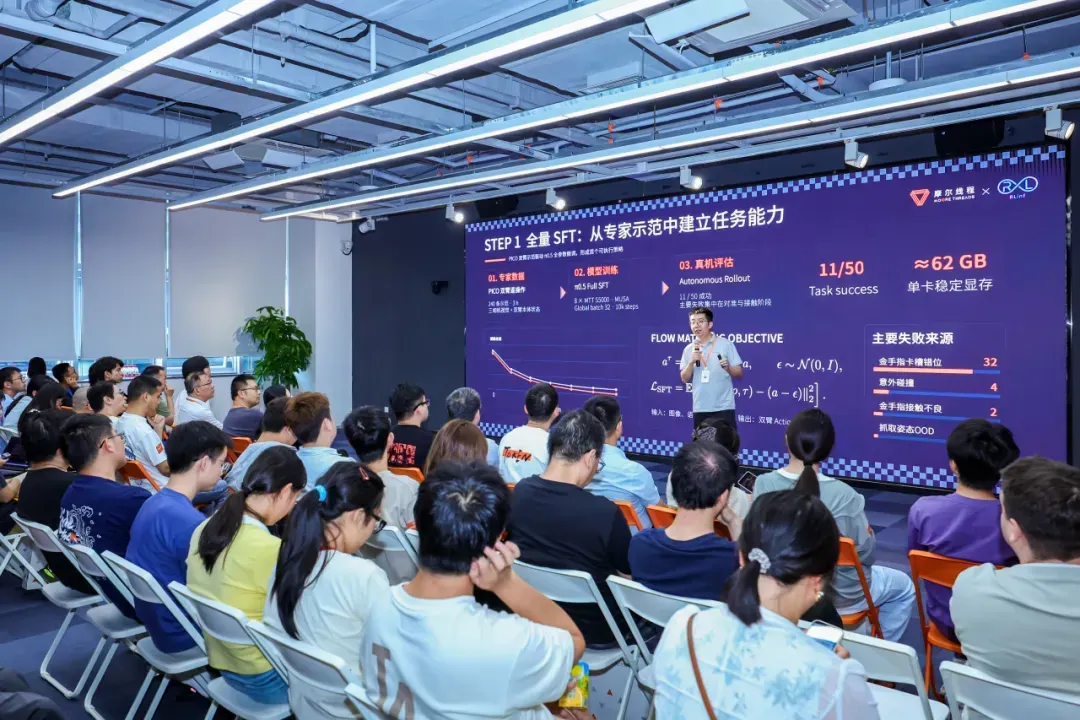
这套飞轮的底层依托是算力与框架的高效协同:MUSA把π0.5全量训练直接落到了单台8卡S5000上,四个阶段共用一套技术栈,无需切换运行环境;RLinf则把原本割裂的四段后训练收敛为一条原生工程闭环,以LeRobot数据契约为桥,加速自定义脚本向RLinf原生编排层平移。
模型落地后,真正的硬仗在真机控制端。面对云端时延,系统通过动作分块让419ms的云端指令赶在530ms执行周期结束前送达,再叠加RTC补偿、时序融合与Ruckig规划,把18.5°的机械臂动作跳变平滑压制到0.23°。后续团队将按“可运行、可加速、可闭环、可验收”四步向端侧SoC芯片迁移,真正实现“云端训练和发布,端侧承担推理、RTC与轨迹执行”的协同闭环。
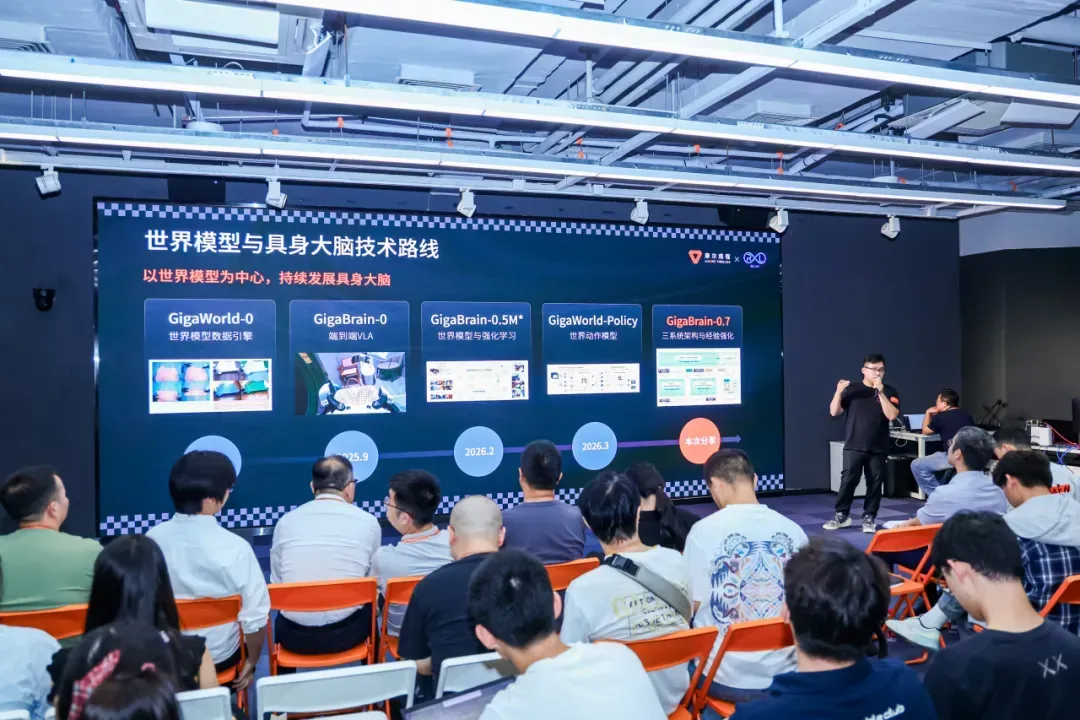
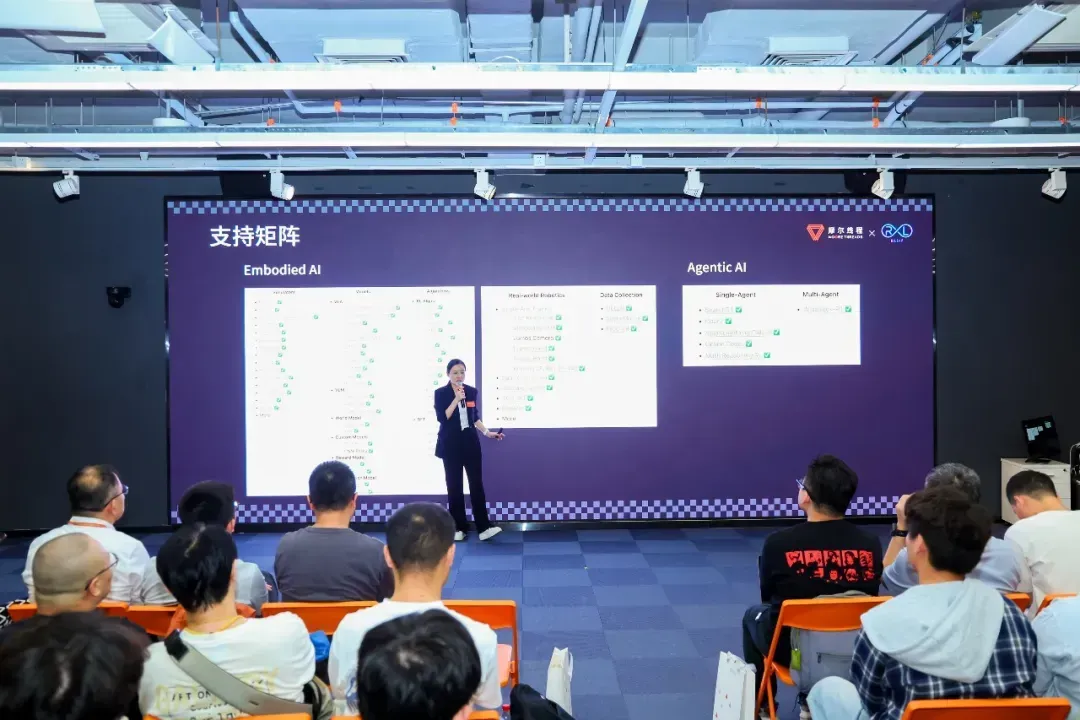
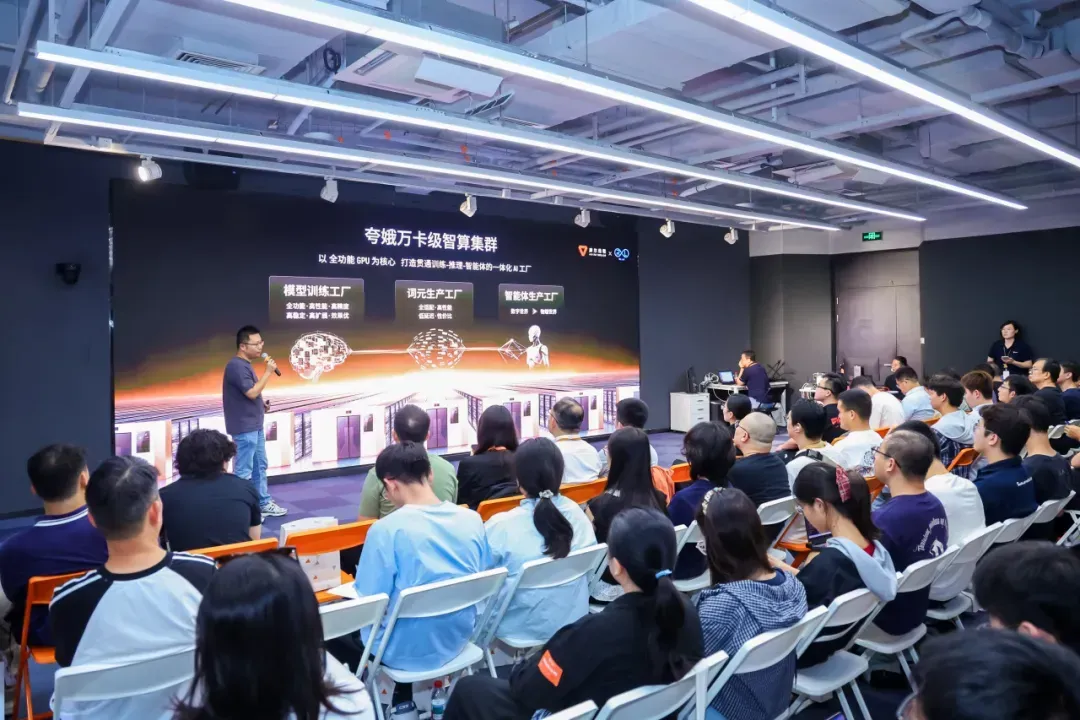
作为国内稀缺的打通“大模型训练-仿真模拟-端侧部署”全链路的GPU企业,摩尔线程以“算、渲、仿”一体的全功能GPU为底座,提出打造面向物理实体的“智能体工厂”。围绕这一体系,摩尔线程向上依托夸娥智算集群与整合物理、渲染、AI三大引擎的MT Lambda仿真平台,向下协同端侧SoC芯片与开发者套件,形成云边端全栈布局,跑通从合成数据、训练到真机部署的工业闭环,并在四足机器狗与双足人形机器人上完成Sim2Real实测验证。目前,MUSA已适配Newton、MuJoCo等主流物理仿真引擎,并接入RoboTwin等仿真环境。
我们的目标是成为具备国际竞争力的GPU领军企业,为融合人工智能和数字孪生的数智世界打造先进的加速计算平台。我们的愿景是为美好世界加速。

- 阿里云加速构建Agentic Cloud:推出AgentCore、新一代CPFS等重磅新品 – 2026年9月22日
- 千问办公发布企业级Agent基础设施“企业上下文” – 2026年9月22日
- 蚂蚁密算韦韬:企业需要的不是更聪明的 AI,而是可信的 AI – 2026年9月22日