FlagOS 作为面向 AI 计算的开源系统软件平台,致力屏蔽底层硬件差异,实现“一次编写、多芯运行”,旨在屏蔽底层硬件差异,打造全球支持芯片种类最多的开源AI系统软件栈,让算力开放、流动、可及;其社区已汇聚芯片厂商、云服务商、高校与独立开发者,形成“芯片—系统—框架—应用”的开放生态。
2026年10月17日,为期两天的“2026人工智能开放计算大会暨众智FlagOS技术大会”在北京中关村国家自主创新示范区展示中心召开。北京智源人工智能研究院副院长兼总工程师林咏华以“众智FlagOS 2.2:从token经济走向物理AI”为主题发表演讲,详细介绍了9月30日发布的FlagOS 2.2这一AI开放计算系统软件栈新版本,标志着开放计算技术生态已经“迈入规模化共享优化的新阶段”。
FlagOS 2.2:AI开放计算系统软件栈新版本
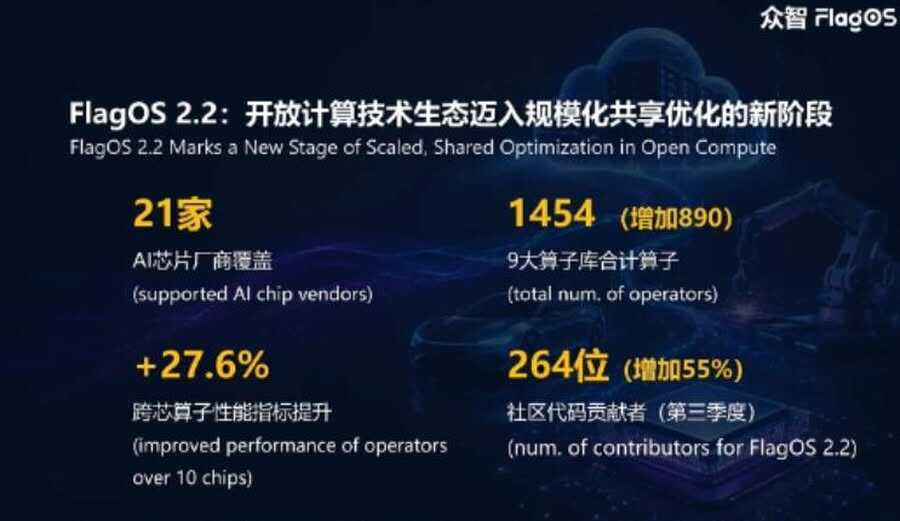
在会上,林咏华展示了旗舰版本FlagOS 2.2的四组关键指标:覆盖21家AI芯片厂商35款芯片;9大算子库合计1454个算子,较上一版增加890个;跨芯算子性能提升27.6%(覆盖10款芯片);社区代码贡献者达264位,较上季度增长55%。
FlagOS 2.2由BAAI智源研究院、众智FlagOS与CSDN社区联合发布,技术架构自上而下分为四层:最上层支持各类AI大模型,涵盖语言、多模态、世界模型与具身智能;中间层通过多芯片统一插件系统适配主流训推框架;下层提供核心开源库与开放工具平台;最底层覆盖AI服务器、边缘设备、AI笔记本、ARM、RISC-V到量子计算等硬件形态,通过统一模型生态、统一软件层与统一硬件入口,让不同硬件共享AI生态。
算子能力层面,FlagGems大模型算子库拥有1224个算子,为全球最大的Triton单一算子库,已进入PyTorch基金会生态;面向vLLM推出FlagGems-vllm支持60个重要融合算子,面向SGLang推出FlagGems-SGLang支持40个融合算子并适配5款以上芯片。混合精度扩展至fused_moe、gemm、sparse_mla等关键算子,加速比最高分别达4.8倍、1.8倍和1.3倍,其中793个算子在不少于5款国产芯片上超过原生算子80%的性能。
编译优化方面,FlagTree编译器单仓库覆盖20个厂商后端,新增支持英伟达TileIR、AMD、平头哥、进迭时空、达摩院、辉羲及ARM64 CPU等后端,main分支升级至Triton 3.6;FlagOSTune自动调优针对矩阵乘等算子搜索提效高达298倍。端到端实测中,英伟达DSV4-flash吞吐提升12.63%、首token时延下降20.22%;摩尔线程S5000运行Qwen3.6-35B-A3B达H100等效算力吞吐的82.29%至89.83%,超越厂商原生4%至19%。通过算子与编译联合优化,跨芯片整体性能提升27.6%,覆盖上千算子和10款异构芯片,其中昆仑芯P800加速比提升191.2%、华为昇腾910B提升160.7%,标志着优化能力从“单点突破”转向“规模化系统性能提升”。
工具链方面,新发布的FlagPrism定位为跨芯片调试与性能分析工具,可深入内核将数值偏差定位到语句级,并清晰展示计算、同步、数据搬运等瓶颈,已支持华为昇腾、天数智芯、摩尔线程、英伟达、燧原等后端。多芯片统一插件系统将“N×M”组合简化为“N+M”解耦模式,实现非侵入式修改,覆盖推理(vLLM、SGLang)、训练(Megatron-LM、TransformerEngine)、强化学习(VeRL)及基础框架(Torch-FL),具备统一发行、接入、运行时、优化四大特性。FlagOS-Compressor首次发布跨芯片统一量化工具,以397B MoE模型为例,W8A8量化后体积减少49.1%,GPQA-Diamond得分保持84.85%,在英伟达H20和国产PPU上完成推理验证。Day0适配能力使新模型可一天内适配运行于多达12款芯片,适配后的多芯片模型版本同步分发至HuggingFace、魔搭社区、腾讯云、焕新社区及国家超算互联网等平台。
众智FlagOS 2.2:从token经济到物理AI的计算支撑
林咏华指出,从Token经济到物理AI正面临三类AI系统挑战。其一是Token工厂,面向训练与推理的规模化系统,痛点在于基础设施更新慢而模型演进快,MoE、长上下文、MTP持续带来新负载。其二是物理世界AI,面向世界模型与具身智能,输入从语言扩展到视频、3D、时空与动作,维度更高、耦合更强。其三是端侧AI,让智能留在设备侧,强调低时延、低功耗,需在隐私、带宽、时延约束下兼顾小内存与高效率。三者算力需求呈现“模型规模×token长度×空间维度×时序帧×生成步数”的复合增长关系。
Token服务案例中,基于FlagOS对DeepSeek V4.1 Flash跨平台优化,英伟达H100推理性能提升18%至20%、64路并发总吞吐约9190 tok/s,平头哥810E提升77%至82%、实现16路并发可用;关键算子中FP4索引打分平均加速2.75倍、FP8 Dense GEMM平均1.41倍。另一案例针对GLM-5.3-Flash在昇腾910B上优化,吞吐实现2.04倍提升,长上下文下冷TTFT下降8.1%、满载ITL下降16.6%,性能达官方API的99.7%,性价比高19.4%至27.6%,体现“让存量算力承接前沿模型”的价值。
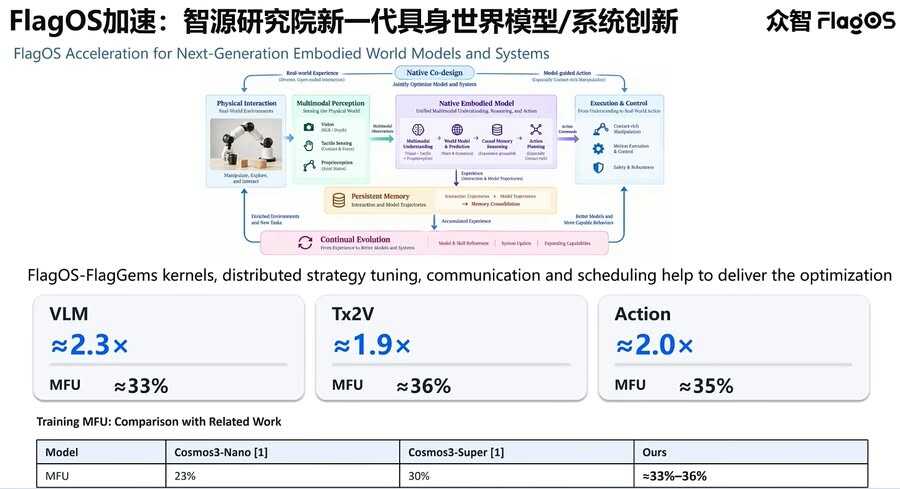
针对世界模型与具身智能,智源研究院构建了“物理交互多模态感知–原生具身模型–执行与控制–持久记忆–持续进化”的闭环架构。性能上,VLM加速约2.3倍、MFU约33%,Tx2V加速约1.9倍、MFU约36%,Action加速约2.0倍、MFU约35%,训练MFU约33%至36%,显著优于Cosmos3-Nano(23%)与Cosmos3-Super(30%)。
端侧AI方面,林咏华强调“端侧AI已突破实用临界点”,驱动力在于“更小的可用模型+更强的本地计算”。边缘芯片算力指数级增长至2026年高通IQ10接近350 TOPS,同时同等能力(GPQA-Diamond约70%)的模型参数从2024年的3000B(o1)在2026年9月降至2.52B(MiniCPM5-2B),两条曲线在2025至2026年间交叉。实测中,FlagOS for Arm CPU环境下仅用CPU运行MiniCPM5-2B,预填充速度即达1135 tokens/s、生成90 tokens/s。通过FlagTree-CPU与SME2、NEON I8MM协同,完整模型Prefill吞吐提升21%至25%,Mac M5 Pro平台上Xing4.0 29B-A4B相对vLLM原生提升252.09%。从云到端侧,ARM支持进一步落实到完整模型优化;基于FlagOS,大模型在ARMCPU的端到端性能有明显提升
FlagOS还赋能新架构用于探索量子世界的创新。10月18日,,由智源研究院与北京量子信息科学研究院(BAQIS)联合推出量智云Quantum-AI Cloud,通过FlagOS Execution Stack支撑FlagQuantum量子框架,对接“九鼎”AI算力系统与“QUAFU”量子计算机,实现量子与经典混合作业调度。
持续繁荣产业及开发者生态
生态建设与国际化是众智FlagOS取得长足进展的重要基础。FlagOS在2026年第三季度开源下载量达464,336次,为第二季度4.76倍,生态成员单位增至107家,新增合作伙伴涵盖凌川科技、中国电子、润开鸿、中国电信、NXP恩智浦、壁仞科技、跨维智能、聆思科技等企业和机构。
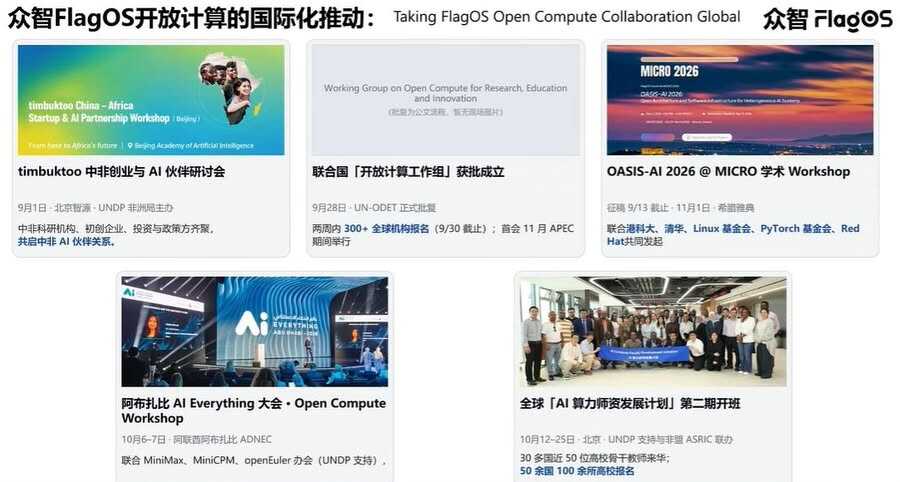
国际化方面,林咏华介绍了多项举措:9月1日在智源举办timbuktoo中非创业与AI伙伴研讨会;9月28日联合国“开放计算工作组”获批成立,两周内超300家全球机构报名,首会计划于11月APEC期间举行;联合港科大、清华、Linux基金会、PyTorch基金会、Red Hat发起OASIS-AI 2026学术Workshop;10月6至7日在阿布扎比举办Open Compute Workshop;全球“AI算力师资发展计划”第二期开班,30多国近50位高校骨干教师来华。
社区层面,FlagOS秉持“开放计算是一场团队协作”理念,支持35种AI芯片、覆盖21家厂商,活跃贡献者超730位、成员组织超100个、覆盖30多国、开发者超55,800人。FlagOS V2.2发布刚半个月,就已在PyTorch、vLLM、SGLang、Megatron-LM、TransformerEngine、VeRL、Triton等主流框架完成集成,FlagCICD核心中间件支持超10种芯片平台。从2.1到2.2版本,合并PR从1890增至4890、新建Issue从420增至1423、代码提交从5100增至9730,代码贡献者达264人、较前增加55%。
毫无疑问,FlagOS 2.2版本的突破正是社区共同研发投入的结晶。
可以预见,随着开放生态持续繁荣,FlagOS 2.2有望成为国产AI基础软件走向规模化共享优化的关键力量,前景值得看好。
(未经本人审定)

- 林咏华:众智FlagOS 2.2发布,token经济正走向物理AI – 2026年10月18日
- AMD Ross发布:智能体AI重塑嵌入式开发全流程 – 2026年10月17日
- 中控技术接入千问办公,打造流程工业领域AI Native标杆企业 – 2026年10月16日