摩尔线程是国内极少数具备万卡规模集群训练能力的GPU企业。大模型训练对底层算子完备度、显存管理与分布式通信的要求极为严苛,是检验国产GPU全栈实力的试金石。依托全功能GPU(Universal GPU)与MUSA软件生态的协同积累,摩尔线程已构建起成熟的工程化体系,具备对前沿复杂大模型从“快速推理部署”到“全链路稳定训练”的支撑能力。
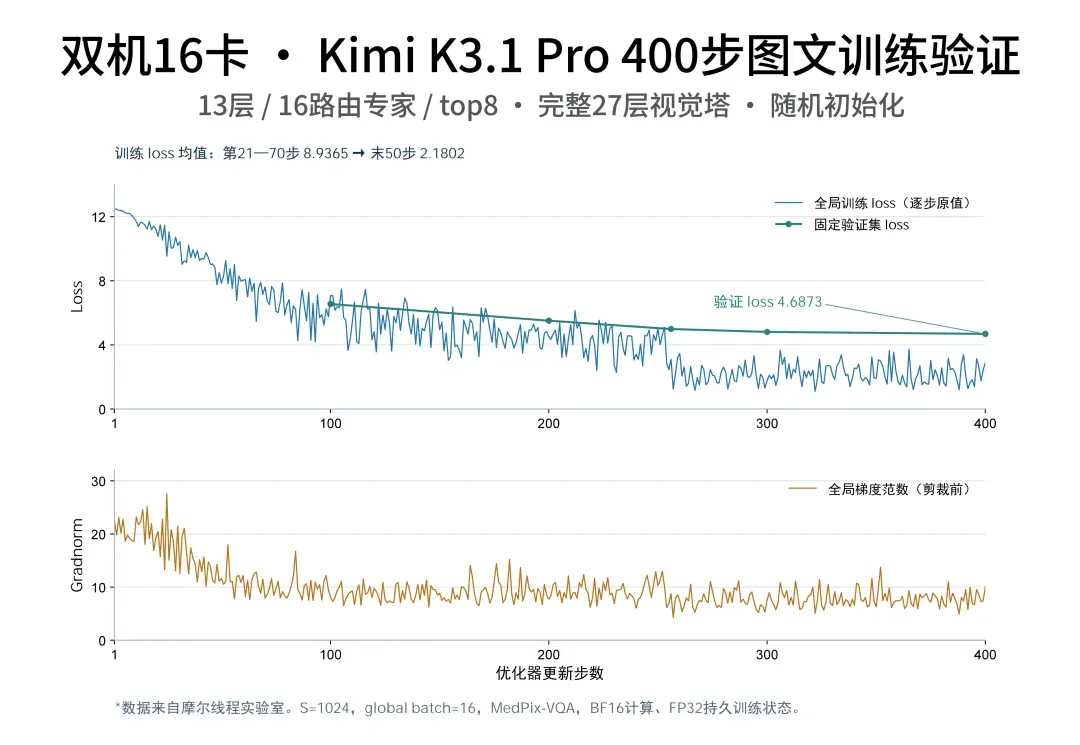
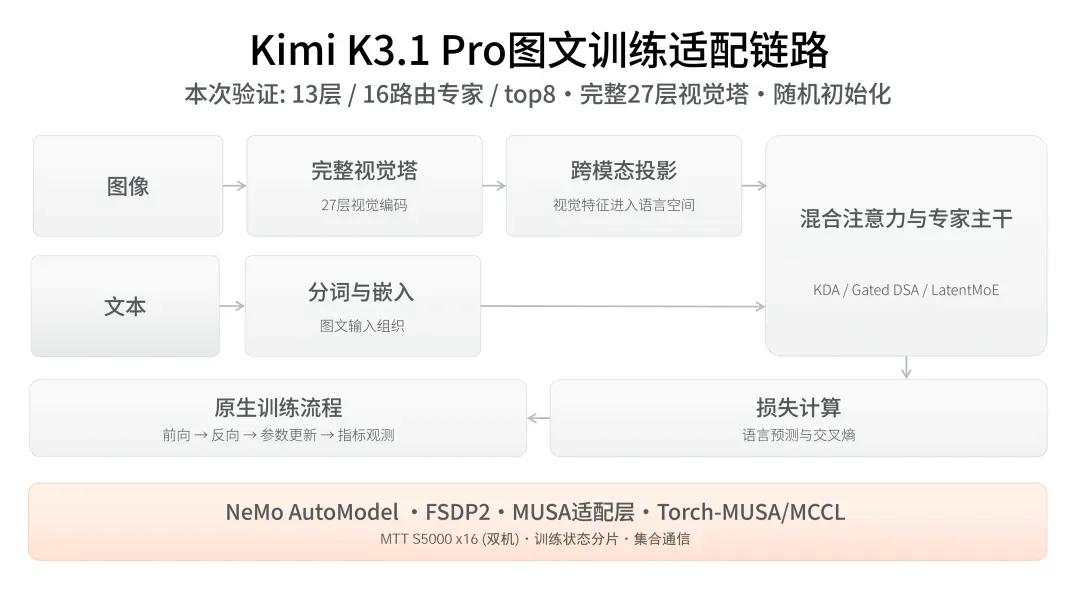
为快速验证跨节点分布式训练基线,本次实验基于13层语言主干、16专家(top-8路由)及完整视觉塔的裁剪配置,采用双机共16张MTT S5000,使用MedPix-VQA图文数据从随机初始化开始训练。
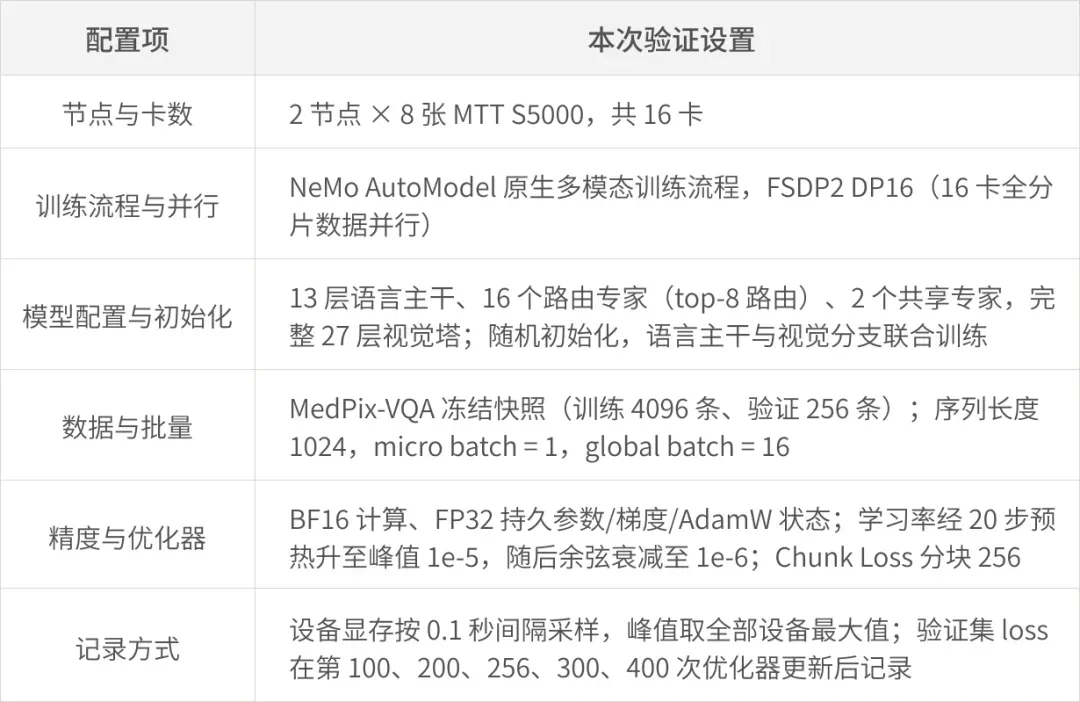
围绕更大专家规模与更长序列的模型训练,摩尔线程从并行策略、通信调度、核心算子和损失计算四个方面完善训练能力,四项优化均已完成适配:FSDP2+EP混合并行、参数预取与梯度通信调度、高性能KDA算子,以及控制大词表显存占用的Chunk Loss分块计算(本轮验证已启用,分块长度256),为更大规模的训练配置提供支撑。
未来,摩尔线程将持续打磨从算子适配、多卡协同到自动化工具链的完整训练能力,推动前沿大模型在国产全功能GPU上从“能训”走向“开箱即训”。

Latest posts by mingzhi (see all)
- 阿里云边缘加速平台ESA全面升级:降低AI应用全球交付与Agent开发的门槛 – 2026年11月18日
- 业内首个!千问办公获11项国际安全合规认证 – 2026年11月18日
- 打通万亿多模态训练链路!摩尔线程完成Kimi K3.1 Pro训练适配 – 2026年11月18日