智东西
作者 | 江宇
编辑 | 漠影
全球具身智能的竞争,正从本体的比拼延伸到 ” 大脑之战 “。
谷歌 Gemini Robotics 2 喊出 ” 一个大脑,适用于任何机器人 “,英伟达 Jim Fan 更是抛出 “VLA 已死,世界动作模型当立 “。谁能成为具身智能的新一代通用模型底座?
国内,宇树科技正在把这件事往前推一步。近日,宇树新一代通用人形机器人基础模型 UnifoLM-WLA-1.0 亮相,6B 参数、约 2500 小时真机训练,具身推理直接拿下 7 项开源 SOTA,多项空间理解任务还反超 GPT-6 Astra。同时,宇树宣布将开放模型、代码和数据集。
对于机器人而言,模型能力还是要落到真实任务中。人形机器人什么时候能进入更多真实场景,实现 ” 通用劳动力 “?宇树正在试图回答这一灵魂一问。
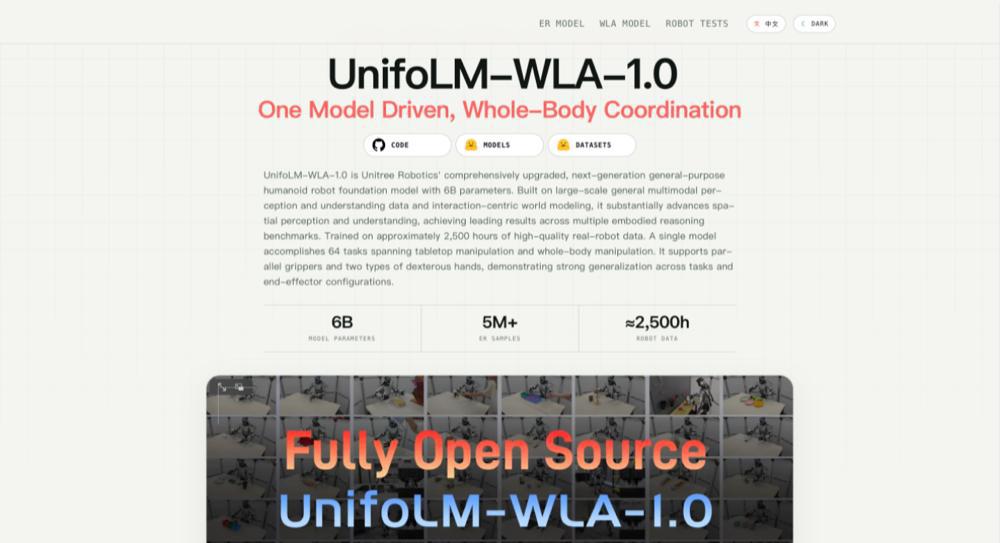
UnifoLM-WLA-1.0 单模型即可统筹 64 项任务,从叠毛巾、收纳餐具,到铺床、倒垃圾、把衣服放进洗衣机,验证了其强大的模型泛化能力。
而这背后藏着行业多年未解的老问题。过去的 Demo 多是单一任务、单一场景、高度定制,演示起来漂亮,换个环境就难复用,始终难以规模化。
而一套模型能否覆盖更多任务、更多场景,恰恰是机器人走向通用的重要一步。宇树此举,正试图让国产厂商成为 ” 具身智能大脑 ” 的定义者。
一、拿下 7 项开源 SOTA,比肩 GPT-6 Astra:国产厂商抢 ” 具身大脑 ” 定义权
先看具身推理能力。UnifoLM-WLA-1.0 的具身推理底座是 UnifoLM-ER-1-4B。该模型基于 Qwen3-VL-4B 训练,使用超过 500 万条具身推理样本,在 16 项多模态感知与理解基准中有 7 项领先表中参评的开源模型。
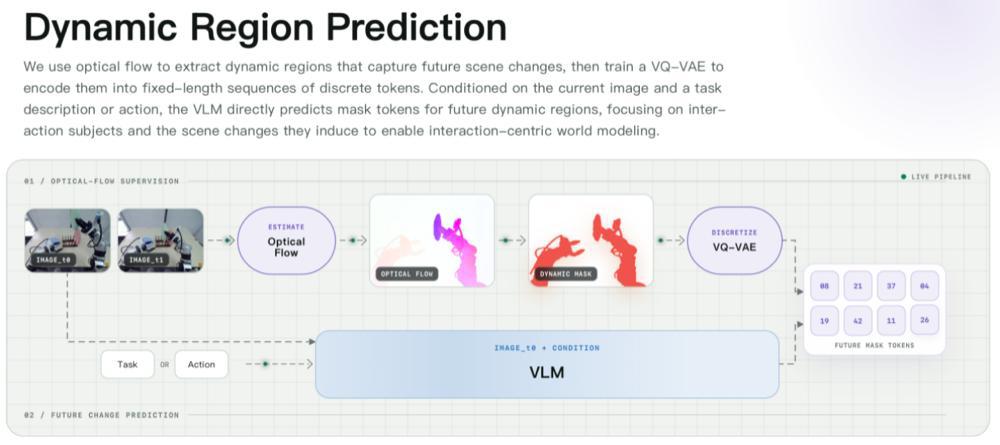
比如机械臂包装手机时,背景里的桌子基本没有变化,真正发生明显变化的是机械臂、手机以及两者发生交互的区域。模型不需要把下一帧画面的每个像素都重新预测一遍,而是把注意力集中到这些因为机器人交互而发生变化的区域。
随后,这些变化区域被 VQ-VAE 压缩成一串固定长度的离散 Token。仅需给定当前画面和任务描述(或将要执行的动作),模型就能直接预测出下一步哪些区域会变。宇树将其称为以交互为中心的世界建模(interaction-centric world modeling)。
有了对未来变化的预测,下一步则是把这种理解真正接到机器人的动作上。
但机器人动作本身又比一句自然语言复杂得多。以人形机器人为例,一次看似简单的 ” 整理沙发抱枕 “,就同时涉及手臂末端往哪里移动、夹爪或者灵巧手如何开合,以及下半身如何配合调整姿态。
如果把所有动作简单塞进一个连续空间里学习,不同身体部位之间的动作表达会非常复杂。
宇树干脆把统一动作空间拆成三路:末端执行器位姿、末端执行器关节、下肢关节,各自用 RVQ 离散成 Token。
原本连续变化的运动轨迹,被翻译成一套 ” 动作语言 “,机械臂怎么走、手怎么动、下半身怎么配合,都有对应的 Token,还按同一条时间轴同步输入。
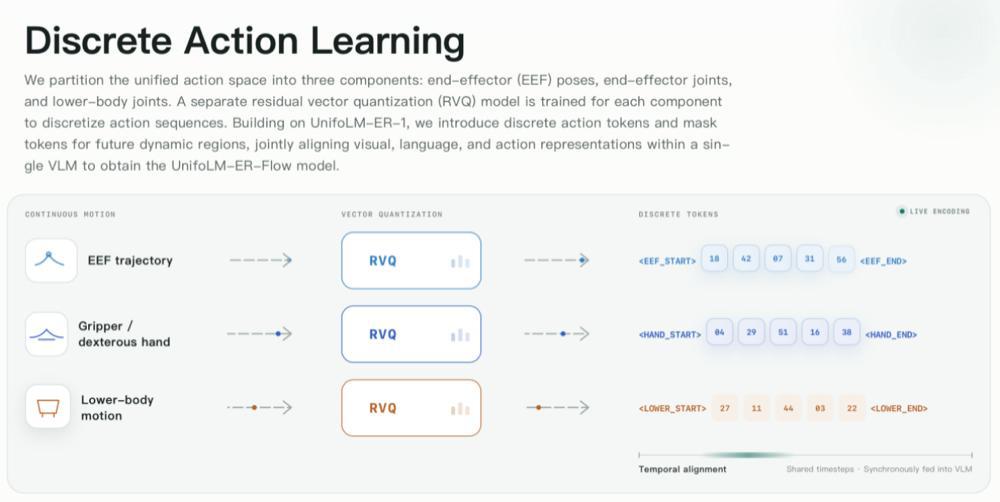
在 UnifoLM-ER-1 的基础上,宇树进一步把这些动作 Token 和前面的未来动态区域 Token,与图像、文字放进同一套表示空间,形成 UnifoLM-ER-Flow。到这里,模型既理解当前看到的世界,也能预测一次交互会让哪里变,还知道该采取什么动作。
但这离真正控制机器人,还差最后一步:离散 Token 适合模型理解和推理,真实机器人最终执行的却是连续动作。
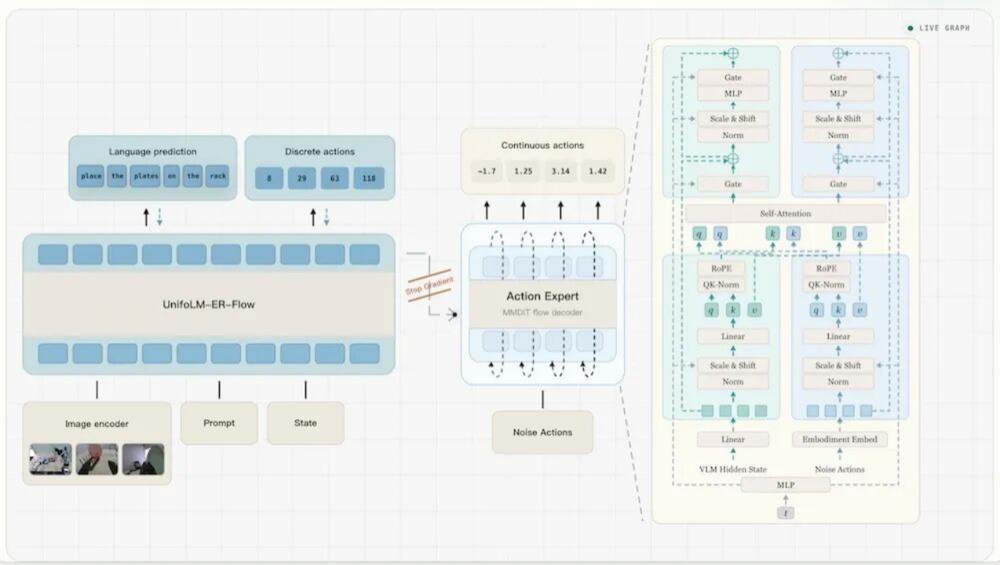
于是到了 UnifoLM-WLA-1.0,宇树在 UnifoLM-ER-Flow 上加入 MMDiT Action Expert,把模型对任务、未来变化和动作的理解,进一步解码成机器人能真正执行的连续动作。
至此,一条完整链路形成了:机器人先预测哪里会变,再生成怎么动。
世界模型由此参与动作生成,使人形机器人能够把环境理解、变化预测和全身控制连接起来。
三、2500 小时真机数据背后:模型是公开牌,数据与场景是护城河
模型参数可以公开,真正难复制的是持续产生高质量机器人数据的能力。具身模型最大的门槛之一,是数据来自真实世界。
原因在于,图文数据可以按亿为单位从互联网上抓取,真机数据却只能让真实的机器人跑出来。2500 小时高质量真机数据,相当于一台机器人连续采集超过 100 天,而且每一帧都要真实、有效、能拿来训练。
UnifoLM-WLA-1.0 使用约 2500 小时真机数据训练,数据覆盖不同的机器人本体和作业场景。
超过 500 万条具身推理样本覆盖图像点预测、物体检测、多图推理、2D 轨迹预测、3D 物体检测和多图空间问答,并与通用图文数据共同训练;约 2500 小时真机数据则用于 WLA 模型训练。两类数据对应不同训练阶段。
真机数据既需要时间,也需要成规模的机器人产能。对只做模型的玩家来说,光是把机器人铺开去采数据,就是一笔绕不开的硬投入。
而另一大技术壁垒则是统一模型。
其把视觉、语言、动态区域 Token 和动作 Token 放进同一个多模态模型,再加入 MMDiT Action Expert 生成连续机器人动作,走出 ” 多本体 + 统一动作空间 ” 的路线,让不同身体部位在同一时间步协同学习。
所以,模型是公开牌,背后真机数据与持续产数据能力才是底牌。
数据决定模型能否持续覆盖更多任务和场景。随着权重、代码和数据逐步开放,开发者可以在 64 项任务之外继续检验模型的泛化边界,并开展二次开发和场景适配。
这也意味着,宇树提供的正在从一台机器人,延伸到一套可以被反复调用、适配不同任务的具身智能底座。对行业客户而言,这样的底座一旦能够被更多机器人、场景和开发者复用,其价值就不再局限于单一硬件,而会进一步延伸到行业解决方案和平台化能力。
换句话说,开源 ” 大脑 ” 并没有削弱宇树的护城河,反而让它进一步落到真机数据、真实场景和持续迭代能力上,再通过开放模型吸引更多开发者和生态伙伴加入。
这条路跑通后,宇树拿得出来的,是一套能持续进化、还能带着生态一起走的底座。宇树的前途,也由此越走越宽。
结语:从定义身体到定义大脑,具身智能进入 ” 生态卡位战 “
从四足到人形,宇树过去一直以本体和运动能力被行业记住。如今,宇树两条腿走路,恰好踩在具身智能竞争的分水岭上:拼硬件的竞争还在加码,拼大脑、拼生态的阶段也正在展开。
当模型参数和代码都能公开,真正稀缺的是持续产出高质量真机数据的能力,以及围绕这套体系聚集起来的开发者生态。
如今,具身智能的 ” 安卓时刻 “,或许正在由国产厂商拉开帷幕。

- 不只强在硬件!宇树6B具身大脑拿下7项开源SOTA,对标GPT-6 Astra – 2026年9月19日
- 宇树科技产业突围:告别参数内卷,以ROI衡量产业价值,人形机器人从“展演”走向真实生产力 – 2026年9月19日
- 半导体与人形机器人的“神经系统” – 2026年9月18日